
Intelligence dossier · 20
Agent Runtime 架构解析:循环、状态、工具与权限
从一次架构对话重新理解 Agent:真正重要的不是更长的提示词,而是循环、状态、工具、权限与验证共同组成的 Runtime。
可以。你可以把 Codex、Pi/oh-my-pi、Antigravity CLI、Claude Code、Gemini CLI 这一类东西统一理解成一种新的软件形态:
LLM Agent Harness / Coding Agent Runtime
它不是“一个会聊天的 CLI”,而是一个围绕 LLM 构建的 事件循环 + 工具执行器 + 上下文管理器 + 权限沙箱 + 会话系统 + 扩展运行时。
真正理解这套架构之后,你再看各种 coding agent,很多设计会突然变得非常统一。
下面我从工程架构角度拆开讲。
1. 先看全局:Coding Agent 本质是什么
最简化的 Coding Agent 可以表示成:
最核心的逻辑甚至可以写成:
while (!done) {
  const response = await model.generate(context);

  if (response.toolCalls.length === 0) {
    return response.text;
  }

  for (const call of response.toolCalls) {
    const result = await executeTool(call);
    context.push(result);
  }
}
这就是 Agent Loop。
Codex 的协议文档里实际上就明确描述了类似的生命周期:一个 Task 由多个 Turn 组成,每个 Turn 调用模型、接收 streaming response,然后执行模型请求的 command / patch,再把输出送进下一轮 Turn;直到模型不再产生需要继续处理的输出。
因此第一件需要建立的认知是:
LLM 本身不是 Agent。
LLM 是 Agent Runtime 里的一个“决策模块”。
2. 真正完整的架构
一个成熟 Coding Agent 通常会变成下面这样:
这才是 Codex / Pi / Antigravity CLI 真正值得研究的地方。
3. 第一核心概念:Agent Loop
普通 Chat
普通聊天基本是:
而 Agent 是:
于是系统从一个:
request → response变成:
observe → reason → act → observe → reason → act也就是经典的:
或者 Agent 领域经常说的:
ReAct
Reasoning + Acting
不过现代 coding agent 并不一定显式输出 Reasoning,它更接近:
甚至可以把它理解成强化学习里的 MDP:
其中:
S = 当前 conversation + filesystem + task state
A = tool call
Environment = OS / repo / git / browser / MCP
4. Agent 最关键的不是 prompt,而是 State
很多人最开始做 Agent 时会过于关注 system prompt。
实际上成熟系统更重要的是:
State Management因为 Agent 每走一步,都必须知道:
所以真正的核心对象通常类似:
interface AgentState {
  messages: Message[];
  model: Model;
  cwd: string;
  tools: ToolRegistry;
  permissions: PermissionState;
  sessionId: string;
  abortSignal: AbortSignal;
}
Pi 的文档就把这种职责拆得非常明显:
其中底层负责 LLM/tool loop,中间层负责 transcript、steering、abort 等状态,上层 AgentSession 再加入模型切换、扩展、skills、session 持久化等 coding-agent 专属能力。
这是一个很值得学习的分层。
5. 为什么一定要有 AgentSession
你可以把:
AgentLoop理解成:
function run(input, tools): AsyncGenerator<Event>它应该尽可能纯。
而:
AgentSession是应用层对象:
class AgentSession {
  history
  model
  settings
  cwd
  extensions
  tools
  permissions

  async prompt()
  async abort()
  async resume()
  async branch()
}
两者不要混在一起。
否则最终会出现一个几千行的:
runAgent()里面同时处理:
非常难维护。
6. 第二核心:Tool 是 Agent 的“系统调用”
这是理解 Agent Architecture 特别重要的一层。
你可以把:
LLM类比成:
CPU / Decision Engine把:
Tool API类比成:
syscallLLM不能直接修改电脑。
它只能产生:
{
  "tool": "read",
  "path": "src/index.ts"
}
runtime 再去执行。
因此:
典型工具:
oh-my-pi 的工具系统就很典型。它将文件读取、写入、编辑、AST 查询、bash 等能力暴露为 agent tools,而且允许控制 active tool set。
7. Tool Definition 为什么通常采用 JSON Schema
例如:
registerTool({
  name: "read_file",

  description: "Read file contents",

  parameters: {
    type: "object",
    properties: {
      path: {
        type: "string"
      }
    },
    required: ["path"]
  },

  execute: async ({ path }) => {
    return fs.readFile(path);
  }
});
模型看到:
Tool:
read_file(path: string)
于是模型可以输出结构化调用。
这背后的思想非常重要:
Tool schema 本质是 LLM 与 deterministic software 之间的 ABI。
有点像:
8. 第三核心:Tool Registry
成熟系统不会写:
if (tool === "read") ...
if (tool === "bash") ...
if (tool === "edit") ...
而是:
class ToolRegistry {
  tools = new Map();

  register(tool) {
    this.tools.set(tool.name, tool);
  }

  async execute(call) {
    return this.tools
      .get(call.name)
      .execute(call.args);
  }
}
于是插件也可以:
pi.registerTool({
  name: "query_database",
  ...
});
oh-my-pi 明确提供:
pi.registerTool(...)
pi.registerCommand(...)
pi.on(...)
因此 Extension 本质上不是“prompt 插件”,而是运行时插件。
9. Hook / Event Bus 才是插件系统真正的灵魂
比如:
Extension 可以监听:
pi.on("tool_call", async event => {
  if (
    event.toolName === "bash" &&
    event.command.includes("rm -rf")
  ) {
    return {
      block: true
    };
  }
});
这会带来一个非常强的模式:
核心逻辑保持稳定。
功能通过插件添加。
10. Skill 和 Tool 是完全不同的东西
这是 Coding Agent 中最容易混淆的概念之一。
Tool
Tool 是:
Capability例如:
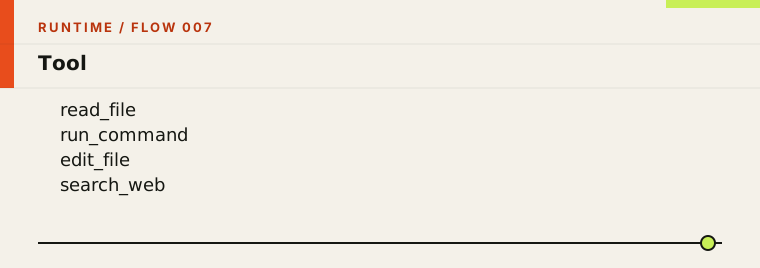
模型能“做什么”。
Skill
Skill 通常是:
Procedural Knowledge也就是告诉模型:
面对某类问题,应该怎么做。例如:
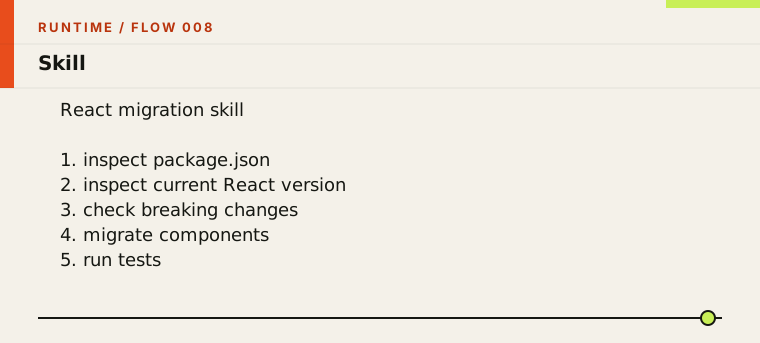
所以:
Tool = 能力
Skill = 方法论
你可以类比:
Tool  ≈ API
Skill ≈ SOP / Playbook
Agent 有 git tool 并不意味着它知道:
如何安全完成 release一个 release skill 可以定义:
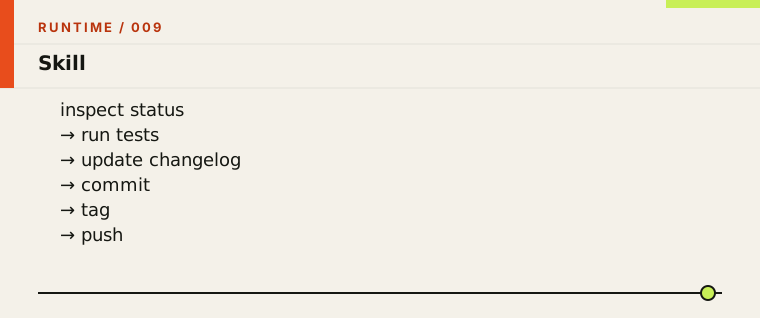
11. Prompt Template 又是什么
Prompt Template 更像:
Macro例如:
于是:
这四个概念一定要分开。
12. MCP 又解决什么问题
如果 Tool Registry 只能加载本地 TS:
那么怎么接:
不能全部写进 agent 本身。
于是:
MCP本质上就是:
远程 Tool Registry Protocol
结构是:
Agent 先:
list_tools然后获得:
github.create_issue()
postgres.query()
jira.search()
之后按照统一协议:
call_tool()13. 为什么 MCP 容易导致 Context Explosion
假设有:
10 MCP servers每个:
30 tools就是:
300 tool schemas每轮 prompt 都送给 LLM:
300 × schema非常浪费 token。
因此现代 Agent 会做:
Tool discovery而不是:
Load everythingoh-my-pi 在这方面有一个挺有意思的设计:常用工具保持激活,较少使用的能力可以通过 discoverable device / namespace 再访问,而不是始终把所有东西塞进 active tool set。
Antigravity 的 release notes 里也能看出同一个工程问题:随着 MCP/plugin/skill 生态变大,它专门提高了每 session 可声明的 tool 数量上限。
14. 第四核心:Context Engine
Coding agent 的本质难题之一其实是:
如何给模型正确的信息而不是:
如何给模型更多信息典型 context 来源:
可以画成:
15. 为什么 AGENTS.md 很重要
Agent 启动之后可以向上搜索:
如果正在操作:
packages/web/src/就可以形成:
root AGENTS.md
      +
packages/web/AGENTS.md
它本质上是:
repository-scoped system prompt也可以理解为:
AI-native README但是它不是面向人的项目介绍,而是:
operational policy for agents16. Context Compaction 是 Coding Agent 的生命线
比如模型:
context window = 200kAgent 做了 100 次工具调用以后,很容易出现:
所以必须做:
Compaction典型策略:
最后 context:
否则很快撞 context limit。
17. 还有一个更高级的问题:Context Pollution
不是只有:
context 太长才有问题。
更多时候是:
context 太乱例如把整个 repo:
1,000 files全塞给模型,效果往往反而下降。
成熟 Agent 更像搜索系统:
即:
Progressive Disclosure18. 第五核心:Permission Engine
Coding agent 有一个与普通 chatbot 完全不同的问题:
它可以执行真实副作用。
比如:
rm -rf
git push
npm publish
curl
kubectl delete
terraform destroy
因此 Agent Runtime 必须有:
Policy Engine而不是简单:
confirm()?19. Policy Engine 通常分两层
Capability Boundary
        +
Approval Policy
可以表示为:
20. Sandbox 和 Approval 不是一回事
这是特别关键的一点。
Sandbox
表示:
物理上能做什么比如:
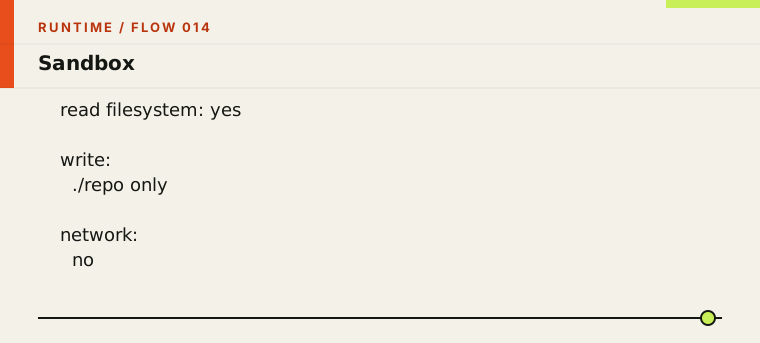
Approval
表示:
什么时候必须问用户例如:
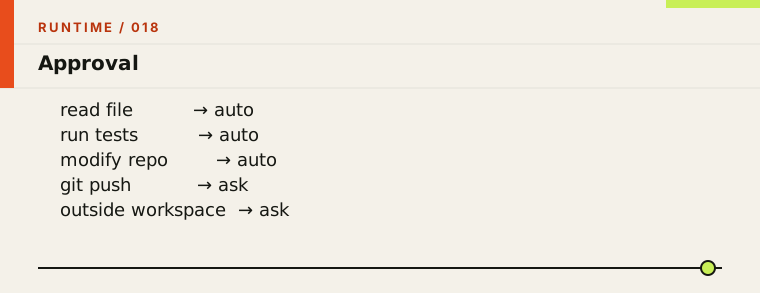
Codex 的设计明确将这两者分开:sandbox 决定执行时技术上允许访问什么,而 approval policy 决定哪些动作需要人工批准。
这个设计极其正确。
21. Codex 的权限设计已经越来越像 capability security
例如某个命令只需要:
network access那么并不意味着:
完全逃逸 sandbox而是可以申请:
network.enabled = true如果需要额外目录:
filesystem.write = /specific/pathCodex 当前的权限机制就支持这种更细粒度的额外 sandbox permissions,而且文档明确倾向于“追加最小权限”而不是直接完全逃逸 sandbox。
这其实已经很接近:
Capability-Based Security思想:
22. Permission 应该围绕 Tool Call,而不是自然语言
错误架构:
这里权限判断依赖 LLM。
危险。
正确架构:
也就是:
Security Boundary 必须存在于模型之外。
23. Antigravity CLI 也明显采用了这种思路
它的 changelog 里可以看到:
例如 proceed-in-sandbox 模式会允许安全 sandbox 内的 command 自动执行,而尝试逃离 sandbox 时才人工确认。
这和 Codex 的方向其实非常接近:
sandbox = primary containment
approval = exception path
24. 第六核心:Edit Engine
Coding Agent 最关键的 Tool 往往不是:
bash而是:
edit最朴素实现:
writeFile(path, wholeNewFile);问题很多:
因此逐渐发展出:
patch25. Patch 的核心思想
例如:
 function add(a, b) {
-  return a - b;
+  return a + b;
 }
模型不用重新生成整个文件。
优点:
26. 但 Patch 还有 stale problem
假设模型看到:
file version A随后别的 agent 改成:
version B这时旧 patch 可能应用错位置。
所以现代 edit tool 会越来越强调:
oh-my-pi 就提供了 hashline patch / content hash anchor,同时也有 ast_edit / ast_grep 这类结构化工具。
这是很先进的方向。
27. Text Edit vs AST Edit
Text edit
简单但容易误匹配。
AST edit
例如:
CallExpression[
  callee.name="foo"
]
然后:
foo(x)
   ↓
bar(x)
它理解:
syntax而不是:
text对于大型 refactor,AST 会越来越重要。
28. 第七核心:Session Persistence
为什么 coding agent 需要 session?
因为工作通常不是:
1 prompt而是:
30 mins
2 hours
3 days
因此需要存:
Antigravity CLI 就明确支持 persistent history,而其 /resume 甚至会扫描持久化 conversation 数据。
29. 一个成熟 Session Model
可以设计:
Session {
  id
  createdAt
  cwd

  turns[]

  model
  systemPrompt

  compactionState

  permissions

  parentSessionId?
}
每个 Turn:
Turn {
  userMessage

  modelResponses[]

  toolCalls[]

  events[]

  tokenUsage
}
30. Event Sourcing 非常适合 Agent
Agent 其实天然是:
event stream比如:
所以内部可以:
event log
      ↓
rebuild session state
这样同时支持:
31. 为什么 Agent CLI 几乎都使用 Streaming
因为任务可能运行:
2分钟
10分钟
30分钟
如果 API 是:
await runAgent();用户体验很差。
更自然:
for await (const event of agent.run()) {
  render(event);
}
例如事件:
{
  type: "tool_start",
  tool: "grep"
}
然后:
{
  type: "tool_result"
}
UI 只是:
Event Consumer32. 这就是为什么 Core 和 TUI 应该解耦
非常好的架构:
oh-my-pi 就明显走的是这个设计。它提供四类入口:
但底层复用同一个 agent engine。
这比:
把 Agent 逻辑写在 CLI handler高级很多。
33. Codex 也是 Core / UI 分离
Codex 的协议里明确把:
Codex和:
UI分开。
UI 可以是:
CLI/TUI
VS Code
GUI
核心 Agent 通过事件/协议与 UI 通信。
这说明现代 agent harness 正在逐渐形成类似:
browser engine
vs
browser UI
的架构。
有点像:
34. 第八核心:Model Abstraction
成熟 agent 基本不会直接:
new OpenAI(...)而是:
Model Provider Interface例如:
interface Model {
  stream(request): AsyncIterable<ModelEvent>;
}
然后:
这样 Agent Loop 不关心:
OpenAI
Gemini
Anthropic
35. oh-my-pi 在这个方向做得非常激进
它支持大量 provider,而且进一步把模型划分成不同 role,例如:
也就是说不再只是:
session.model而是:
role → model这引出了非常重要的架构思想:
不要把 Agent 和 Model 一一绑定。
36. Model Router
例如:
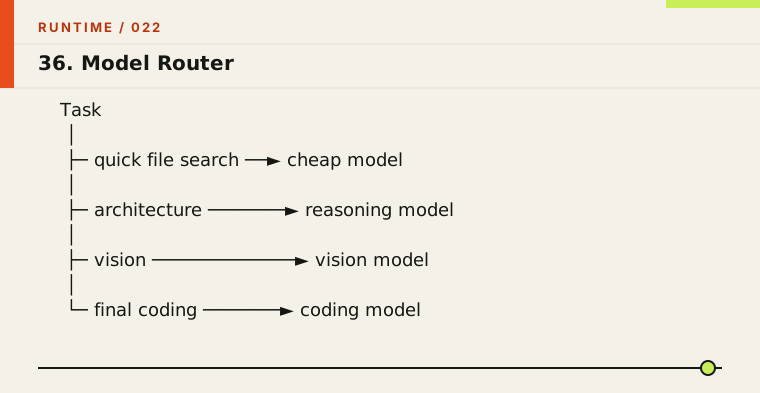
本质:
model = router.select(task);这会极大降低成本。
37. 第九核心:Subagent
当任务复杂后,一个 Agent 容易出现:
context pollution
attention dilution
serial bottleneck
例如:
分析一个大型 repo一个 agent 顺序做:
很慢。
于是出现:
Subagent38. Subagent Architecture
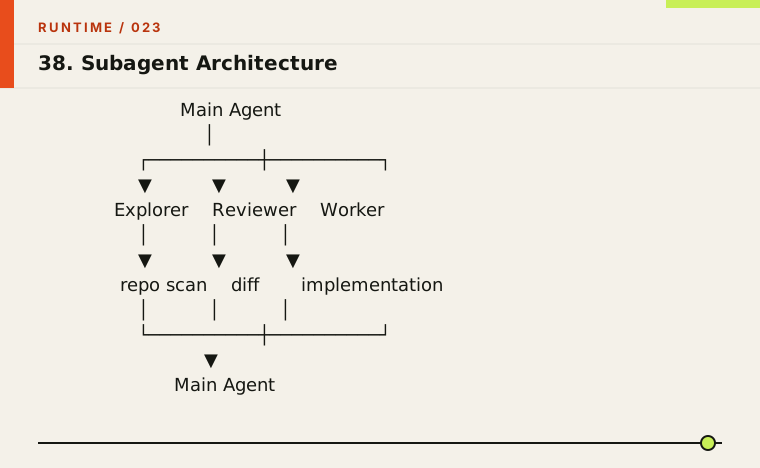
关键:
39. Subagent 不应该只是“另一个 prompt”
一个好的 Subagent API 类似:
spawnAgent({
  role: "explorer",
  prompt,
  tools: [
    "read",
    "grep"
  ],
  model: "cheap-fast"
});
Explorer:
read-onlyWorker:
read + editReviewer:
read + git diff所以:
Agent = policy + model + tools + context而不是:
Agent = prompt40. Tool Permission 和 Subagent 是天然绑定的
比如:
Explorer永远不需要:
rm
git push
write
因此:
Principle of Least Privilege可以自然落到 Agent 上。
Pi 类实现里也可以按 subagent 设置 included/excluded tools,这正是正确方向。
41. 第十核心:Plan Mode
很多 coding agent 有:
plan mode真正目的并不是:
先输出待办项而是:
将 reasoning / exploration 与 mutation 解耦。
即:
然后:
安全性高很多。
42. 可以把 Agent 看成状态机
失败:
Verifying
   │
   └── fail ──► Exploring
这比:
“LLM 自己想怎么办”稳定很多。
43. Agent 的真正核心可以抽象成六个东西
如果你以后自己写,我建议记这个公式:
不是:
Agent = LLM + Prompt44. 再加上产品层,就是
完整一点:
45. Codex、oh-my-pi、Antigravity CLI 的侧重点差异
从当前公开资料来看,可以粗略这样理解:
| Codex | oh-my-pi | Antigravity CLI | |
|---|---|---|---|
| 核心定位 | 安全的 coding runtime | 高度可扩展 agent harness | Antigravity agent 的 terminal frontend |
| Agent loop | 强 | 强 | 强 |
| Session | 强 | 强 | 强 |
| Sandbox | 非常强 | 可扩展 | 强 |
| Approval | 精细 | Hook/政策可扩展 | 权限规则体系 |
| Plugin | Skills / Hooks / MCP 等 | 非常强调 Extensions | Plugins / skills / agents / MCP |
| Multi-model | OpenAI 为中心 | 极强 | Google 模型体系 |
| SDK | 有 | 很强 | 独立 SDK |
| RPC | App Server | RPC / ACP | 更偏共享 agent engine |
| TUI | 有 | 很强 | 很强 |
| Subagent | 已成为重要组成 | 强调 role/subagent | 有 specialized agents |
| 核心特色 | security/runtime | hackability/extensibility | terminal 与 Antigravity 平台统一 |
Codex 的协议和 app-server 文档尤其体现出“核心 runtime + 任意 UI client”的设计。
oh-my-pi 则更像一个“Agent hacker toolkit”:SDK、RPC、ACP、ExtensionAPI、tool registration、model registry 都被暴露出来。
Antigravity CLI 的定位则更接近“同一 Agent Engine 的 terminal surface”;官方 README 明确说 CLI 和桌面 Antigravity 使用 shared core agent engine。
46. Antigravity 的 SDK 分层也很值得参考
它目前公开 SDK 的抽象大致是:
这个结构非常合理:
Agent是易用 API。
Conversation承载 agent semantics。
Connection负责:
因此可以把 agent engine 放:
local process
remote service
desktop app
上层代码基本不变。
47. 这类工具下一步都会向“Agent OS”发展
我认为架构演进路径大致是:
阶段 1

LLM CLI
↓
↓
↓
↓
阶段 5

Agent OS
Agent OS 里面会有:
这个类比非常准确。
48. 甚至可以做一张对应表
| Operating System | Agent Runtime |
|---|---|
| Process | Agent / Subagent |
| Thread | Tool execution / worker |
| Scheduler | Orchestrator |
| Syscall | Tool call |
| Kernel | Agent runtime |
| Filesystem | Workspace/context |
| Shell | Bash tool |
| ACL | Permission policy |
| Sandbox | Sandbox |
| IPC | MCP / ACP / RPC |
| Package | Skill/plugin |
| Device | External tool |
| Terminal | TUI |
| Process state | Session |
| Log | Transcript / event log |
这也是为什么我觉得:
“Agent Framework”这个名字其实有点低估它。
成熟 coding agent 已经越来越像:
AI Runtime / AI OS49. 如果你自己实现一个 Mini Codex,我建议这样分目录
比如 TypeScript:
这个目录结构已经非常接近一个工业级 coding agent 的骨架。
50. 最核心的几个接口可以长这样
Model
interface Model {
  stream(
    context: ModelContext
  ): AsyncIterable<ModelEvent>;
}
Tool
interface Tool<TInput, TOutput> {
  name: string;
  description: string;
  schema: JSONSchema;

  execute(
    input: TInput,
    ctx: ToolContext
  ): Promise<TOutput>;
}
Policy
interface PolicyEngine {
  evaluate(
    call: ToolCall,
    context: AgentContext
  ): Promise<
    | { action: "allow" }
    | { action: "deny"; reason: string }
    | { action: "ask"; reason: string }
  >;
}
Extension
interface ExtensionAPI {
  registerTool(tool: Tool): void;

  registerCommand(
    name: string,
    handler: CommandHandler
  ): void;

  on(
    event: string,
    handler: EventHandler
  ): void;
}
Session
interface AgentSession {
  prompt(
    input: string
  ): AsyncIterable<AgentEvent>;

  abort(): void;

  compact(): Promise<void>;

  save(): Promise<void>;
}
如果这几个 interface 设计对了,整个架构基本就立住了。
51. 最后,我建议你用“四层模型”理解所有 Agent 工具
以后你遇到任何一个:
都可以先问四个问题。
第一层:
Brain谁负责决策?
LLM
model router
subagents
第二层:
Runtime如何运行?
第三层:
Capability能做什么?
第四层:
Governance什么可以做?
最终:
这个模型基本可以解释现在绝大多数 coding agent。
我认为最值得你重点研究的源码顺序
如果你的目标不只是“使用这些工具”,而是想真正学会怎么设计一个 Coding Agent,我建议按这个顺序看:
- Agent Loop:先搞清楚 model → tool → result → model 的循环。Codex 的 protocol 文档非常适合建立概念。
- AgentSession / State:重点看 oh-my-pi 这一层怎么把 runtime 包成 session。
- Tool Registry + Edit/Bash:理解 LLM 与 OS 的真正边界。
- Extension / Event system:看 oh-my-pi 的
registerTool / registerCommand / on。 - Sandbox / Approval:重点研究 Codex,这块工程价值很高。
- MCP / Skills / Subagents:最后再研究能力扩展和 orchestration。
如果把前四项真正吃透,你自己用 TypeScript/Bun 写一个 Mini Codex / Mini Pi,核心代码其实不需要特别多;难点主要集中在 context engineering、sandbox、编辑可靠性、session lifecycle 和复杂异常状态,而不是 LLM API 本身。