
Intelligence dossier · 20
AI Team 架构:以 Product Graph 驱动多 Agent 协作
真正的 AI Team 不靠增加角色和群聊形成,而是让产品、设计、工程与验证围绕同一张 Product Graph 交付可追踪制品。
可以,而且我建议把它从一开始就定义成 AI Team Runtime / AI-native Software Company,而不是 Multi-Agent Chat。
最核心的设计思想可以压缩成一句话:
人负责目标和最终授权;AI Team 负责把目标转成 Product Graph 中一系列可验证的 Artifact,并通过专业 Agent 协作持续推进产品状态。
也就是说,系统的中心不是 Agent,也不是 Conversation,而是:
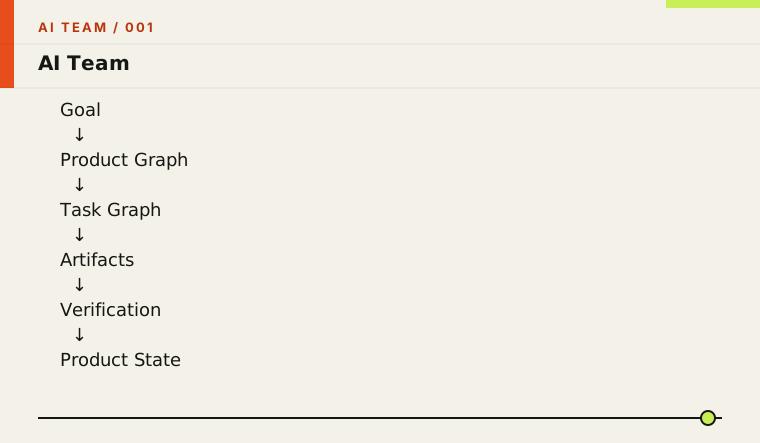
一、先定义最终形态
我会把整个 AI Team 设计成六层:
这里最重要的是:
AI Team ≠ 一堆 Agent。
更准确:
二、组织架构:不要一开始就做 20 个 Agent
我建议第一版固定六个“职位”。
不过这里有一个很关键的区分:
Lead ≠ Worker
例如:
Engineering Lead不应该天天自己 edit() 文件。
它负责:
真正操作代码的是:
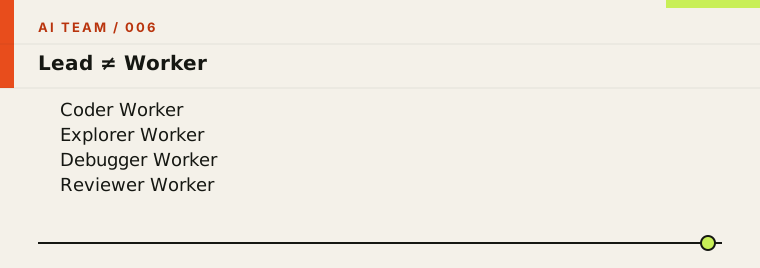
因此组织结构应该是:
Role
├ Lead Agent
└ Worker Agent
三、第一层:Product Lead
Product Lead 是整个 AI Team 的入口。
用户说:
给我们的 SaaS 增加团队邀请功能。
Product Lead 不应该马上:
叫程序员写代码而应该先产生:
ProductGoal然后:
然后建立:
FeatureProduct Lead 的能力
它不应该拥有:
shell:write
git:push
production:deploy
它的主要 Tool:
四、第二层:Product Graph —— 整个系统最重要的东西
这是我认为 AI Team 与普通 Multi-Agent 最大的区别。
不要让团队共享:
一大串 conversation而是共享:
Product Graph例如:
这个 Graph 才是:
公司的真正共享大脑。
五、Product Graph 的节点类型
我大概会定义:
type ProductNode =
  | Goal
  | Requirement
  | Feature
  | UserStory
  | UserFlow
  | Decision
  | Design
  | Component
  | Api
  | DatabaseModel
  | CodeModule
  | Test
  | Issue
  | Release
  | Metric
  | Feedback;
例如:
你就拥有了:
Requirement → Code → Test的完整 traceability。
六、它甚至比 Git 更高一个层次
Git知道:
哪个文件发生了变化Product Graph知道:
为什么发生变化例如:
这就是整个 AI Team 的:
semantic source of truth七、Artifact Graph 和 Product Graph 要分开
这里还要再精细一点。
Product Graph 表示:
产品是什么Artifact Graph 表示:
工作是怎么完成的比如:
工作过程中:
所以:
Product Graph = Semantic State

Artifact Graph = Work Evidence
这是一个很重要的分离。
八、第三层:Task Graph
Product Lead 把 Product Graph 中的变化编译成:
Task Graph例如:
注意:
这已经不是:
Agent A → Agent B → Agent C而是:
Task DAGAgent只是:
Task executor九、Scheduler 决定“谁来做”
例如:
Task:
Implement Team Invitation API
Scheduler查看:
然后选择:
Backend Worker所以:
assign(task) {
  candidates = findAgents(task.capabilities);

  return scheduler.select(
    candidates,
    {
      cost,
      quality,
      availability,
      contextLocality,
      trust
    }
  );
}
这就开始很像 Kubernetes scheduler。
十、Agent 不应该固定成“一个人格”
这是另一个关键设计。
不要:
const bob = new ProgrammerAgent()更好的方式:
例如:
interface AgentDefinition {
  role: AgentRole;
  skills: Skill[];
  capabilities: Capability[];
  modelPolicy: ModelPolicy;
  instructions: string;
}
运行时:
十一、AI Team 里最好只有少量 Persistent Agents
例如:
因为它们需要:
生命周期:
months / years而:
应该大多是:
Ephemeral Workers生命周期:
task所以:
十二、Product Lead 不应该直接调用所有 Worker
我建议增加:
Department Lead形成:
这样组织层级非常自然。
十三、Design Department
完整结构:
职责:
UX Researcher
负责:
主要输出:
ResearchArtifact
UserFlowArtifact
UI Designer
输出:
DesignFrame
ComponentSpec
Prototype
Design Critic
负责:
十四、Engineering Department
Explorer
不写代码。
只:
输出:
CodeResearchArtifactCoder
只根据:
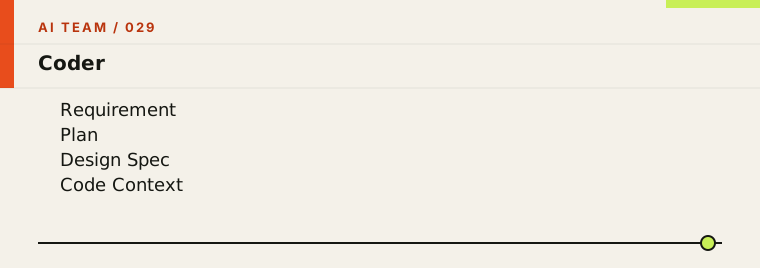
生成:
PatchArtifactReviewer
尽量:
read-only负责:
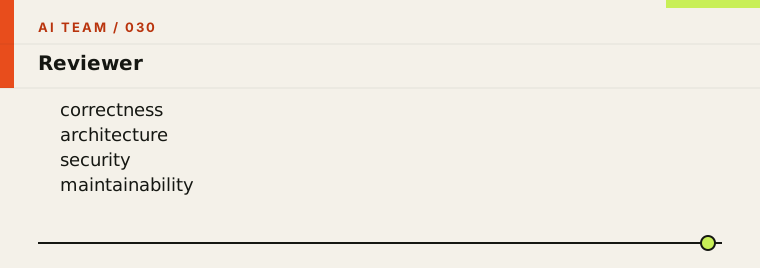
十五、QA Department
这个我认为很多 Agent Team 都低估了。
实际上 QA Agent 应该具有非常高的地位。
QA不应该问:
“代码看起来好吗?”而是:
十六、整个系统应该围绕“Evidence”工作
我特别推荐定义:
Claim
+
Evidence
例如 Coder说:
“登录 Bug 修复了”不重要。
重要的是:
于是:
interface Claim {
  statement: string;
  evidence: ArtifactRef[];
  confidence: number;
}
这会极大提高 Agent 系统可靠性。
十七、定义一个统一的 Work Contract
每个 Agent 接收:
interface WorkOrder {
  id: string;

  objective: string;

  inputs: ArtifactRef[];

  constraints: Constraint[];

  acceptanceCriteria: Criterion[];

  workspace: WorkspaceRef;

  capabilities: Capability[];

  outputSchema: ArtifactSchema;
}
例如:
Agent不能随便交一段话回来。
必须:
produce(outputSchema)十八、Agent之间真正的通信协议不是 Chat
内部最好是:
WorkOrder
   ↓
Artifact
也就是:
Worker → Lead:
Artifact {
 ...
}
这样系统非常容易:
十九、Blackboard 负责共享“当前工作状态”
Product Graph:
长期产品事实Artifact Store:
工作产物Blackboard:
当前 task 的共享工作状态例如:
所有 Worker:
read blackboard
write structured updates
避免:
互相同步 100K token 聊天记录二十、Memory 要做到 Team Memory,而不只是 User Memory
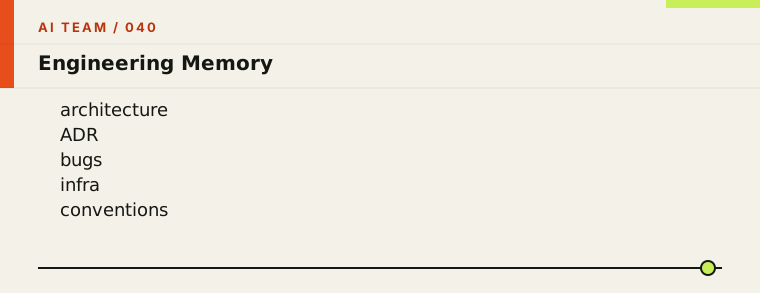
AI Team 至少需要五类 memory:
Product Memory
Engineering Memory
Design Memory
Organizational Memory
User Memory
preferences
working style
priorities
二十一、再建立 Decision Memory
这个我认为尤其重要。
很多团队最大的知识实际上是:
为什么当初这么做?所以单独定义:
interface Decision {
  question: string;

  options: Option[];

  selected: Option;

  rationale: string;

  evidence: ArtifactRef[];

  decidedBy: AgentId | UserId;

  validFrom: Date;

  supersedes?: DecisionId;
}
例如:
这样未来 Programmer 不会三个月后:
重新争论一遍二十二、AI Team 必须区分 Autonomous / Approval
我建议动作分四档:
例如:
| Level | 动作 | 默认策略 |
|---|---|---|
| L0 | read/search/test | 自动 |
| L1 | 修改 sandbox 代码 | 自动 |
| L2 | 创建 PR/发 Slack | policy |
| L3 | merge/deploy/pay/delete prod | 人工审批 |
所以:
二十三、让不同部门拥有不同 Capability
例如 Design:
Engineering:
QA:
Product:
不要:
everyone = *二十四、协议怎么放
现在可以非常清楚地放进去。
MCP
Agent → Tool例如:
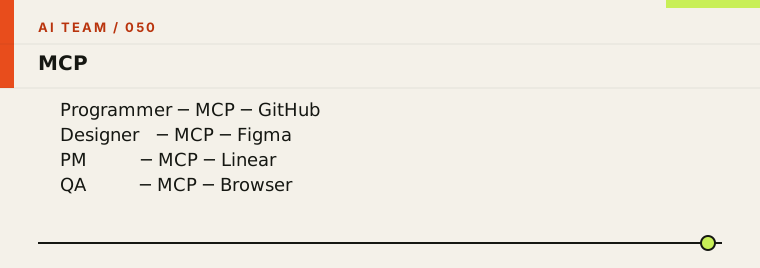
MCP 在 2026-07-28 版已经转向 stateless core,并把 Tasks、Apps 等能力放入 extension framework,同时继续加强 authorization,非常适合做这一层工具边界。
A2A
不是内部 Worker 默认协议。
内部:
spawnAgent()就够了。
如果:
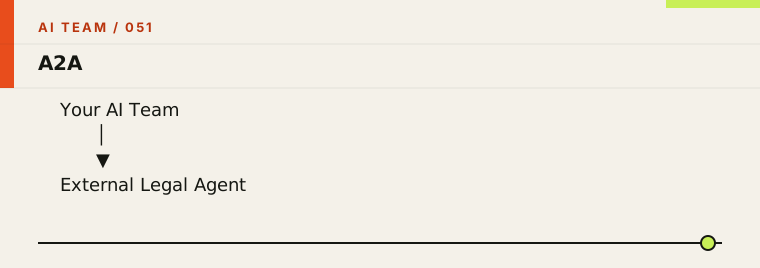
才:
A2AA2A 1.0 已经是稳定的 agent-to-agent interoperability 协议,而且现在明确定位为横向的 agent orchestration layer,与作为 agent→tool 垂直集成层的 MCP 互补。
ACP
用于:
IDE / UI → AI Team所以开发者可以在 VS Code:
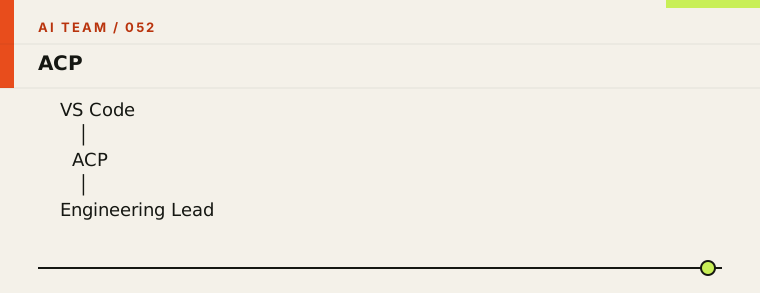
而不用专门给每一个 Coding Agent 做 VS Code 插件。
二十五、真正复杂任务交给 Durable Workflow
例如:
完成 Checkout 2.0可能持续一天甚至一周。
不能:
await agent.run();一直挂着。
应该:
Agent Worker 随时:
Task不受影响。
二十六、一个完整 Feature 是怎样完成的
现在假设你对 AI Team 说:
给我们的 SaaS 加一个 Dark Mode。
理想执行过程:
这才是我认为真正像“团队”的执行。
二十七、还有一个很重要的 Agent:Integrator
多 Agent 最难的不是:
生成结果而是:
整合结果所以我要增加:
Integrator Agent结构:
Integrator负责:
二十八、再加一个 Critic,不要所有 Lead 自我验证
形成经典:
三者不同。
Generator
创造Critic
找问题Verifier
证明例如:
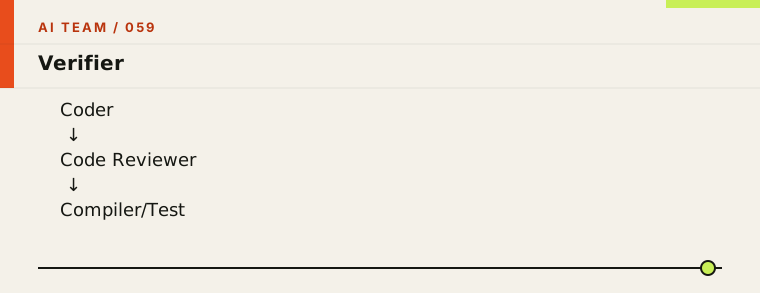
Designer:
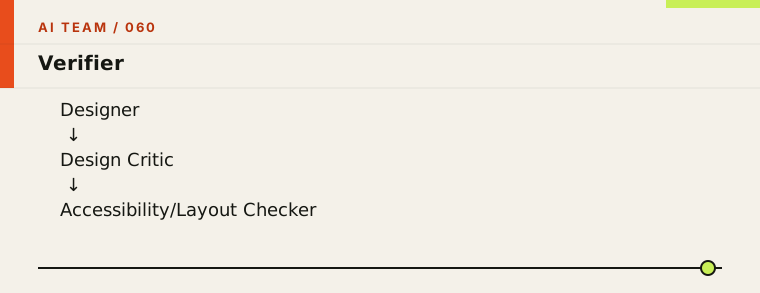
这就是:
Generate
Critique
Verify
三层。
二十九、失败机制必须一开始就设计
例如测试失败:
不要:
失败 → 再问同一个 Agent这是一个很关键的提升。
三十、Escalation 应该像真实公司
定义:
例如:
Agent不是无限 retry。
三十一、成本也是 Scheduler 的一部分
AI Team 如果有几十个 Worker,很容易:
token burn所以 Task 应该有:
interface TaskBudget {
  maxTokens?: number;
  maxCost?: number;
  maxModelCalls?: number;
  maxDuration?: number;
}
Scheduler可以:
不是:
GPT-X strongest everywhere三十二、每个 Agent 应该有自己的 Context Budget
不要让 QA 看全部:
QA只需要:
Designer只需要:
Coder只需要:
所以:
这叫:
Context Projection
我认为这会成为 AI Team 极其重要的机制。
三十三、最终真正需要的数据库可能长这样
文件:
Workspace则:
Sandbox / Git三十四、核心数据关系
最终你会得到一张非常漂亮的图:
这实际上形成了:
Product Development Loop三十五、这时候 AI Team 就可以自己主动发现任务
这是更高级的一步。
今天:
Human → Task → Agent未来:
例如监控发现:
checkout error rate ↑系统:
这时候团队开始真正:
event-driven三十六、甚至可以构建“公司 Operating System”
再往后:
共享:
于是:
形成闭环:
这其实比所谓:
AI Employee更有意思。
因为你在构造的是:
AI-native Organization Runtime。
三十七、我建议 V1 只做 7 个 Agent
如果现在真的开这个项目,我不会一开始做几十个。
就:
其中:
Product Lead
Design Lead
Engineering Lead
Persistent。
task scoped。
三十八、V1 技术栈
我会这样落:
注意:
V1 我不会马上 Neo4j。
直接:
PostgreSQL建立:
nodes
edges
就够。
等 Product Graph复杂到真正需要图数据库,再换。
三十九、我甚至建议核心目录这样设计
注意这里:
agents/只是整个代码库的一小块。
这是对的。
如果你的项目目录 80% 都是:
agents/*.ts一般说明架构还停留在 Multi-Agent Demo。
四十、核心 Runtime API 可以极简
最终 Agent Runtime 可能只有:
interface AgentRuntime {
  execute(
    order: WorkOrder,
    context: ExecutionContext
  ): AsyncIterable<AgentEvent>;
}
Team Runtime:
interface TeamRuntime {
  createTask(goal: Goal): Promise<Task>;

  delegate(task: Task): Promise<AgentInstance>;

  submitArtifact(
    task: Task,
    artifact: Artifact
  ): Promise<void>;

  verify(
    artifact: Artifact
  ): Promise<VerificationResult>;
}
Product Runtime:
interface ProductRuntime {
  queryGraph(query: ProductQuery): Promise<ProductNode[]>;

  mutateGraph(change: ProductChange): Promise<void>;

  trace(
    node: ProductNode
  ): Promise<ProductTrace>;
}
这三个 interface 基本就是整个系统的骨架。
四十一、真正的“AI Team Dashboard”应该长什么样
不要只做:
Chat UI主页应该是:
你不需要盯着:
Agent 正在思考……
Agent 正在思考……
你只关心:
这才是老板/Team Lead 的视角。
四十二、Task 页面也不是 Chat
应该是:
Chat只是辅助入口。
Graph / Artifact / Evidence 才应该是主 UI。
四十三、最后把整个 AI Team 压成一个公式
我会这样定义:
而不是:
两者差别非常大。
四十四、我认为这里真正有壁垒的是 4 个东西
Agent Loop本身很容易被替代。
模型也会不断变化。
真正值得你自己掌控的是:
Product Graph 决定团队“知道产品是什么”。
Artifact Protocol 决定 Agent 如何协作。
Context Engine 决定每个岗位“知道什么”。
Verification 决定系统“什么时候敢相信 Agent”。
Codex、Pi、Claude、Gemini、未来更强的 Agent,最终都可以插进你的 Worker 层。
最终形态
如果这个方向真的做好,我甚至不会把产品叫:
Multi-Agent Framework。
更准确的定位会是:
AI Team Operating System
或者:
Autonomous Product Development Runtime
它运行的不是一个 Agent,而是:
这形成了一个真正的 闭环软件组织。
而如果准备实际把它写出来,我会把下一步锁定在 Product Graph + Artifact Protocol + WorkOrder 三个基础模型上:先不碰 UI,也先不堆很多 Agent。把这三个 schema 设计正确之后,Programmer、Designer、PM、QA 都只是不同的执行器;这才是最值得先打牢的地基。