
Build dossier · 20
可替换 Agent Platform:控制面、运行时与执行面的分层设计
理想的 Agent Platform 不追求包办一切,而是让控制面、Runtime、耐久编排、执行面与制品流各自拥有唯一职责。
可以。把我们前面聊过的 Codex / Pi / OpenClaw / Hermes / MCP / ACP / A2A / Memory / Sandbox / Durable Execution 全部放到一起以后,我认为当前最理想的方案不是:
“找一个最强 Agent 框架。”
而是:
搭一个 Agent Platform,把 Agent Runtime 本身设计成可替换组件。
截至 2026 年 9 月,我会倾向下面这套。
1. 我心中的“理想 Agent Stack”
这套架构最核心的思想是:
每层职责独立。
2. 如果真让我今天开工,我会怎么选
我会选择:
| 层 | 推荐 |
|---|---|
| 主语言 | TypeScript |
| Agent Harness | 自己写轻量 Core,参考 Pi/Codex |
| Coding Agent | Codex / Pi-compatible adapter |
| Client Protocol | ACP |
| Tool Protocol | MCP |
| Agent Protocol | A2A 1.0 |
| Durable Execution | Temporal |
| Agent Graph | 自己的状态机;复杂场景可 LangGraph |
| Primary DB | PostgreSQL |
| Cache/Event | Redis |
| Artifact | S3-compatible storage |
| Memory | Graphiti + PostgreSQL/vector search |
| Persistent Agent | 可以借鉴 Letta |
| Sandbox | Daytona 或 E2B |
| IAM | OIDC/OAuth + capability token |
| Policy | 自己的 Policy Engine |
| Observability | OpenTelemetry + Langfuse |
| Eval | deterministic verifier + LLM judge |
| Gateway | 自己做,借鉴 OpenClaw |
| Deployment | Docker/Kubernetes |
| Messaging | Kafka/NATS 可选 |
| Model | Multi-provider Model Router |
但里面有一个非常重要的选择:
我不会直接把 LangGraph 当整个系统的核心。
也不会:
Everything = OpenClaw或者:
Everything = Temporal或者:
Everything = Letta我会让它们各自在自己擅长的层工作。
3. 最底层应该是 Sandbox,而不是 Agent
很多人会先写:
const agent = new Agent(...)我的设计反过来。
一个 Task 首先创建:
Workspace例如:
interface Workspace {
  id: string;

  filesystem: FileSystem;
  sandbox: Sandbox;

  repo?: Repository;

  environment: Environment;

  capabilities: Capability[];

  secrets: SecretLease[];
}
然后:
不是:
4. Sandbox:我目前倾向 Daytona
Daytona 现在已经把 sandbox 做得非常接近我们前面讨论的:
Agent Computer它给每个 sandbox 独立 kernel、filesystem、network stack、CPU/RAM/disk,并同时提供 Linux container、Linux VM、Windows、GPU 等运行形态。还支持 snapshot / pause / resume 等能力。
于是 Agent 不应该获得:
shell()而应该获得:
workspace.shell.exec()例如:
另一个:
互不影响。
E2B 也很好,而且目前已经直接集成到 OpenAI Agents SDK,可提供隔离执行、持久 workspace state、parallel sandbox 等能力。
我的选择:
5. Workspace 应该支持 fork
这是我认为非常值得做,但现在很多 Agent 系统做得还不够好的一点。
例如一个 Bug:
Fix authentication race condition主 Agent 可以:
然后比较:
选择最优。
这比:
高级很多。
6. Agent Runtime 我反而建议自己写“小”
这里我会学 Pi,而不是上来 LangGraph。
Agent Core 应该非常薄:
interface AgentRuntime {

  run(
    task: Task,
    context: AgentContext
  ): AsyncIterable<AgentEvent>;

}
内部核心只有:
就是:
while (!completed) {

  const context =
    await contextEngine.build(state);

  const output =
    await model.generate(context);

  for (const action of output.actions) {

    const decision =
      await policy.evaluate(action);

    const result =
      await toolRuntime.execute(
        action,
        workspace
      );

    state.apply(result);
  }
}
整个核心最好:
几千行而不是几十万行。
7. Model 绝不能直接绑定 Agent
设计:
例如:
type ModelRole =
  | "fast"
  | "reasoning"
  | "coding"
  | "vision"
  | "review"
  | "summarization";
然后:
这样才能真正控制:
cost
latency
reliability
8. Agent 不直接拥有 Tool
这是一个非常重要的设计。
不要:
agent.tools = [
  shell,
  github,
  database
]
而应该:
比如:
Worker:
filesystem.read
filesystem.write
shell.execute
Release Agent:
filesystem.read
git.commit
git.push
每个 Agent 最小权限。
9. MCP 就放在 Tool Runtime 里面
截至 2026 年 7 月,MCP 最新规范已经进一步向一个更加干净的 protocol core 演化,包括 stateless core、MRTR、header routing、authorization hardening、extensions 等。
所以内部工具:
Builtin Tool和外部:
MCP Tool应该对 Agent 完全透明。
例如:
Agent 看起来都是:
tool.call()10. Tool Schema 不应该全部进入 Context
300 个 MCP tools 全塞进去是错误的。
应该有:
Tool Discovery Layer流程:
例如:
而不是把:
也塞进去。
11. Context Engine 要作为独立服务
我认为未来优秀 Agent 系统里最核心的组件之一不是 Agent Loop,而是:
Context Engine接口类似:
interface ContextEngine {

  build(
    task: Task,
    agent: Agent,
    budget: TokenBudget
  ): Promise<ModelContext>;

}
它从:
这里要负责:
12. Memory 应该拆成四种
不要:
memory = vector database我建议:
Working Memory
当前 task:
存在:
Agent StateEpisodic Memory
发生过什么:
2026-09-01
修过 payment race condition
最终是 Redis lock 导致
Semantic Memory
事实:
project backend = NestJS
database = PostgreSQL
deploy = AWS
Procedural Memory
经验:
也就是:
Skills13. 我会使用 Graphiti 管“事实世界”
Graphiti 最大价值不是普通 graph RAG,而是:
temporal facts它能维护:
事实何时成立
何时失效
来源是什么
并结合 semantic、full-text 和 graph retrieval。官方定义就是 temporal Context Graph。
比如:
比:
vectorDB:
Alice Google
Alice OpenAI
靠谱得多。
14. Letta 思想则适合“长期人格 Agent”
如果是类似 Hermes/OpenClaw 的个人 Agent:
我会借鉴 Letta。
Letta 在 2026 年 8 月发布的 Agents SDK 就明确把 Agent 定义成持久、stateful 的实体:它可以跨机器运行,同时保留 identity、long-term experience 和 memory。
所以:
Coding Task Agent和:
My Personal Agent不应该完全是同一个生命周期。
前者:
ephemeral后者:
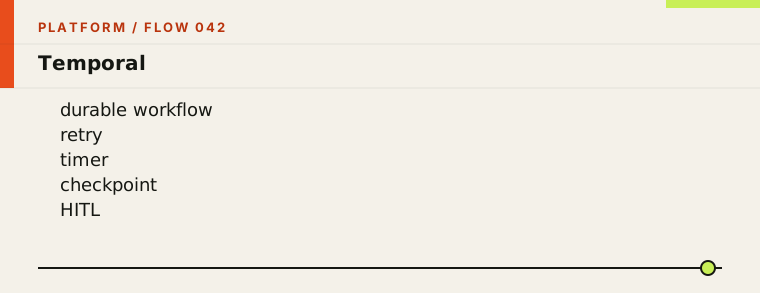
persistent identity15. Durable Execution:我会选 Temporal 做最底层保证
这里我的倾向很明确。
如果任务可能:
就进入:
Temporal因为 Temporal 的核心保证就是 workflow 即使遇到 crash、network failure、infrastructure outage,也能够恢复执行。官方现在也明确把 AI agents 列为这种 durable workload。
所以:
或者:
16. 为什么我不直接“全部 LangGraph”
LangGraph非常适合:
现在它已经明确提供 durable execution、streaming、persistence、memory 和 HITL。
例如:
它很舒服。
但如果:
我还是更愿意:
Temporal做外层 durable workflow。
所以:
而不是:
LangGraph = entire backend17. 一个理想 Task 的执行过程
假设用户说:
“帮我给项目增加 Stripe subscription,然后开 PR。”
完整流程应该是:
注意:
模型不是控制整个业务生命周期。
Temporal 是。
18. 关键结果应该叫 Artifact,而不是 Message
这是我很推荐的设计。
不要:
Planner agent:
"我觉得可以这么做……"
然后 Worker 靠自然语言读。
改成:
interface PlanArtifact {

  goal: string;

  files: FileChange[];

  constraints: Constraint[];

  validation: TestPlan[];

}
然后:
Coder:
PatchArtifactTester:
TestArtifactReviewer:
ReviewArtifact最终:
这样整个系统才:
19. Multi-Agent 我不会做“Agent 聊天群”
不要:
很浪费 token。
用:
Blackboard / Artifact Store更合理:
Agent之间主要交换:
structured artifacts而不是聊天历史。
20. A2A 只用于真正独立的 Agent
这个边界特别重要。
当前 A2A 1.0 的定位已经非常明确:用于不同、甚至内部完全 opaque 的 agent systems 之间发现能力、委派任务和交换结果。
所以:
同一个 runtime 的 subagent不用 A2A。
直接:
spawnAgent()即可。
而:
你的公司 Agent
     ↓
外部 Legal Agent
才:
A2A所以:
21. ACP 则放在 UI 边界
对于 coding:
Agent 不应该为每一个 UI 实现协议。
统一:
ACP现在本身就是为了消除 editor × agent 的 N×M 集成问题,并且明确类似 LSP。
这样:
22. Gateway 层我会借鉴 OpenClaw,但不把 OpenClaw 当 Kernel
Gateway负责:
例如:
然后 Gateway 后面才是:
Agent Platform这样未来换:
都可以。
23. Security 我会独立出 Policy Engine
任何 tool execution:
然后:
不能:
LLM 自己决定风险24. Secrets 也不能直接暴露给 Agent
错误:
process.env.AWS_SECRET然后模型:
可以看到 credential正确:
甚至 Agent 根本看不到 secret:
这是最理想。
25. Agent IAM 最终应该是 Capability-Based
例如:
它派生 Reviewer:
不能 write。
Main Agent派生 Deployment Agent:
deploy:staging也没有:
deploy:production只有用户批准后:
这才是我认为成熟 Agent OS 应该有的安全模型。
26. Event Store 必须是一等公民
所有东西变成 event:
例如:
这样一个 Agent 的全部生命周期:
可以 replay
可以 debug
可以 audit
27. Observability:OpenTelemetry + Langfuse
我不会让 Langfuse成为 Runtime dependency。
Runtime只输出:
OpenTelemetry例如:
然后 exporter:
Langfuse 当前非常适合 agent trace:它会记录 LLM calls、tool invocation、retrieval、control-flow steps,并提供 evaluation/cost/latency 分析。
其 2026 年 v4 甚至进一步优化到直接查询和评估每个 agent step/tool execution。
28. Verifier 必须独立于 Generator
这个是整个系统最重要的质量设计之一。
不要:
而应该:
最终:
confidence来自:
evidence而不是模型自己说。
29. Model Judge 应该放最后
Verifier优先级:
例如:
TypeScript code先:
最后才:
Reviewer Model不要反过来。
30. Scheduler 最好也不是 Agent 自己 sleep
错误:
await sleep(86400000);Agent:
一天后检查正确:
Temporal Timer
Cron
Event trigger
流程:
Agent 本身保持:
event-driven31. Personal Agent 与 Worker Agent 要分离
我会定义两种核心 Agent:
Persistent Agent
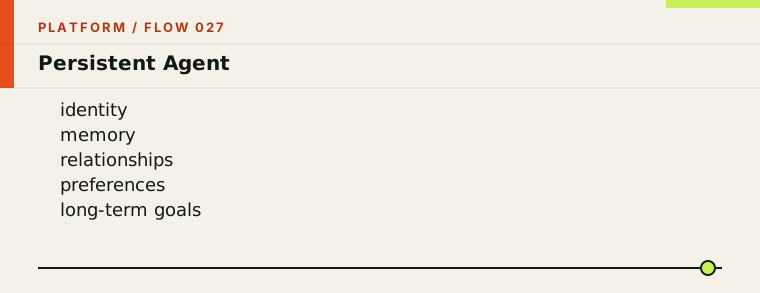
类似:
Hermes
Letta
OpenClaw assistant
生命周期:
months / yearsEphemeral Worker
task scoped
minimal permissions
minimal context
例如:
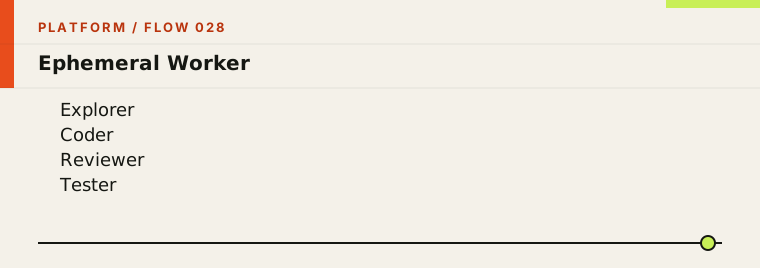
生命周期:
seconds / minutes结构:
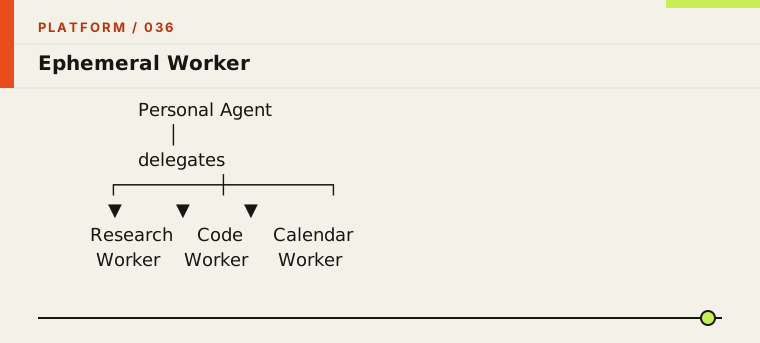
这比一个 Agent 包办所有事合理得多。
32. 也就是说 OpenClaw/Hermes 最终应该在这一层
不是:
OpenClaw
   =
所有 execution runtime
33. 最终的协议关系会非常漂亮
建议你记住:
我目前认为:
ACP + MCP + A2A是一个非常值得押注的协议组合。
其中 A2A 当前已经进入 Linux Foundation / Agentic AI Foundation 体系,并明确定位成与 MCP 互补的 horizontal orchestration layer。
34. 整套系统的数据模型
如果我自己做,核心对象大概就是:
User

Identity

AgentDefinition

AgentInstance

Task

Run

Workspace

Capability

Tool

Skill

Memory

Artifact

Event

Approval

Checkpoint
关系:
35. 最关键的是 AgentDefinition 和 AgentInstance 分开
类似:
Docker Image
vs
Container
定义:
AgentDefinition {
  role
  instructions
  modelPolicy
  capabilities
  skills
}
实例:
AgentInstance {
  id
  definitionId
  taskId
  state
  workspace
  model
}
于是:
ReviewerDefinition可以创建:
Reviewer #123
Reviewer #124
Reviewer #125
这其实就是:
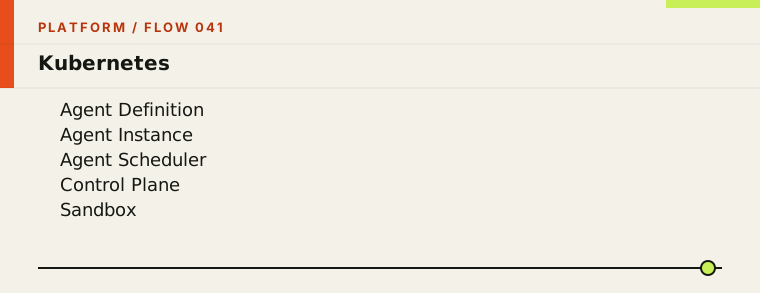
Agent as Process36. Scheduler 就像 OS Scheduler
Control Plane:
考虑:
然后调度 Agent。
这才真正接近:
Agent OS37. 最终我会把整个平台分成 Control Plane / Data Plane
这个来自 Kubernetes,也是我觉得最合适的架构。
Control Plane
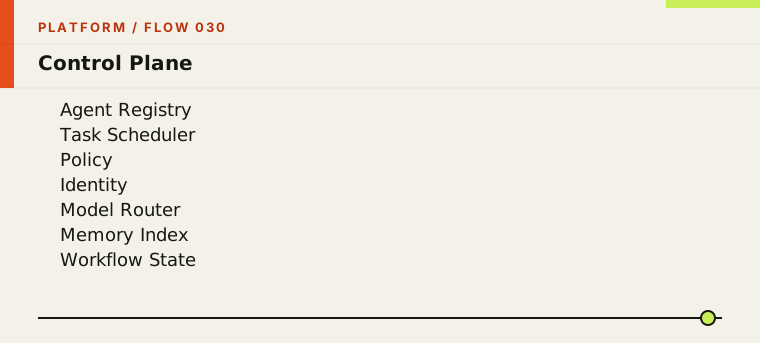
负责:
decideExecution Plane
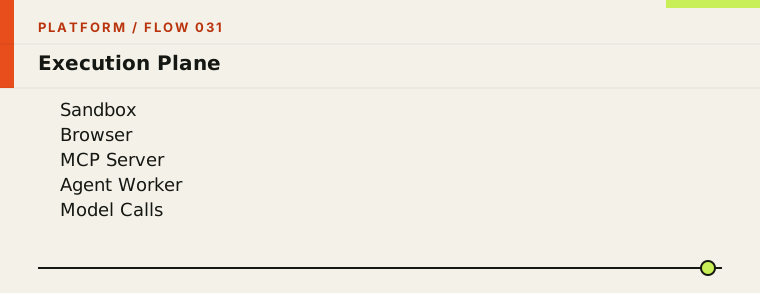
负责:
execute结构:
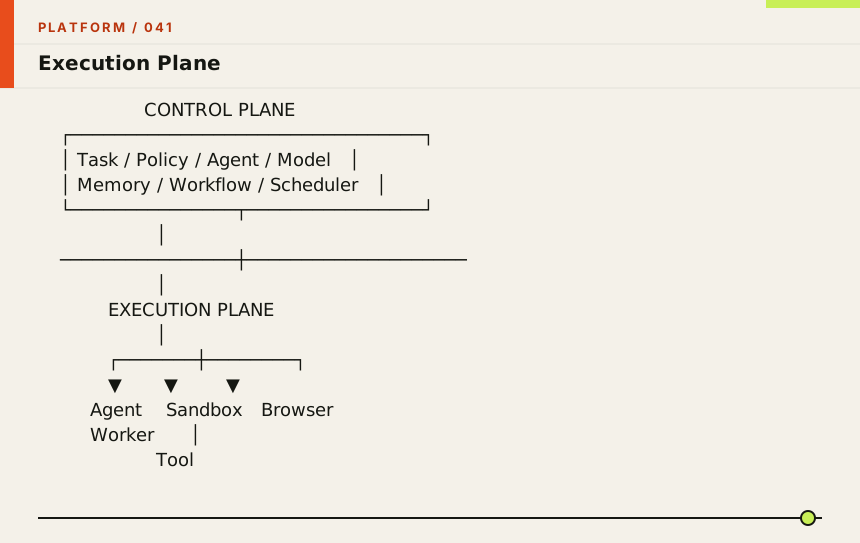
38. 如果是个人开发者,我不会第一天全部实现
“最理想架构”和“第一版应该怎么做”是两回事。
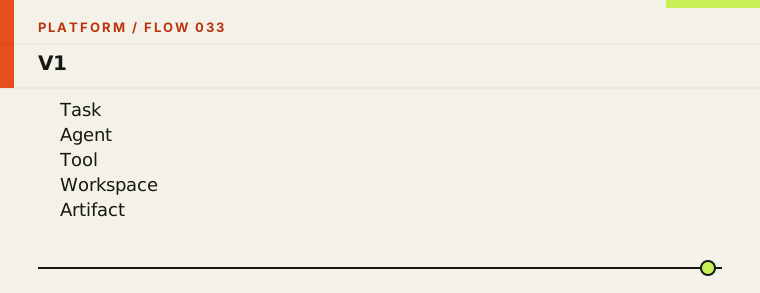
我会分四阶段。
V1
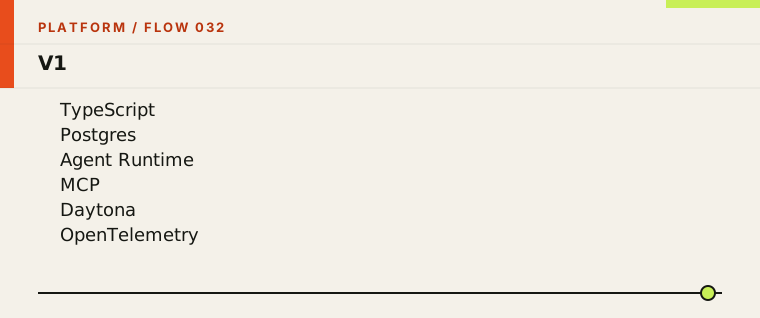
先实现:
V2
加:
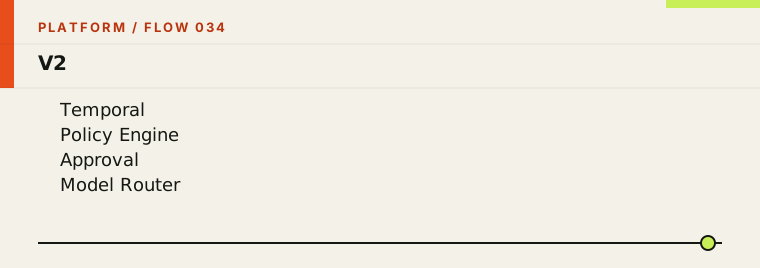
此时已经:
production capableV3
加:
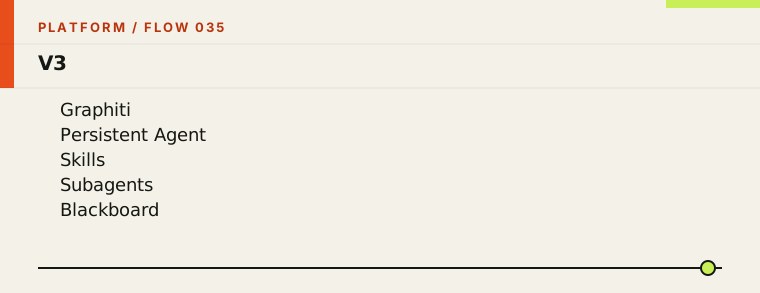
开始拥有:
长期智能V4
加:
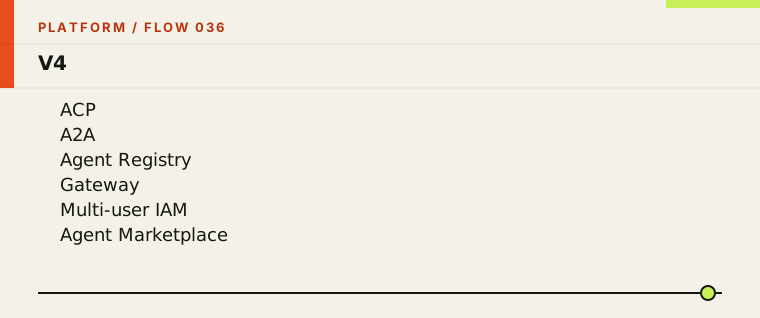
这时候才真正:
Agent Platform / Agent OS39. 如果只能选一个我认为“最佳组合”
我会这样定:
这就是我目前认为最干净的一套。
40. 为什么不是直接采用 OpenClaw + Codex + LangGraph + Letta 全堆起来?
因为那样会产生:
典型结果:
谁才是真实状态?所以核心原则是:
同一种职责只允许一个 canonical owner。
例如:
不要重复。
41. 这是整个架构最重要的一张“职责表”
| 问题 | 谁负责 |
|---|---|
| Agent 下一步做什么? | LLM |
| Agent 如何循环? | Agent Runtime |
| Agent 正在执行到哪里? | Temporal |
| 当前 Task 状态? | PostgreSQL |
| Agent 长期记得什么? | Memory |
| Agent 看哪些上下文? | Context Engine |
| Agent 能用什么? | Capability Registry |
| Agent 是否允许执行? | Policy Engine |
| 命令在哪里运行? | Sandbox |
| 外部 Tool 怎么接? | MCP |
| 其他 Agent 怎么接? | A2A |
| IDE 怎么接 Agent? | ACP |
| 谁在操作? | Identity/IAM |
| 如何恢复? | Checkpoint / Temporal |
| 如何验证正确性? | Verifier |
| 如何 Debug? | OTel / Langfuse |
| Agent 如何主动工作? | Event/Scheduler |
| Agent之间交换什么? | Artifact |
只要这张表不混乱,整个系统基本不会失控。
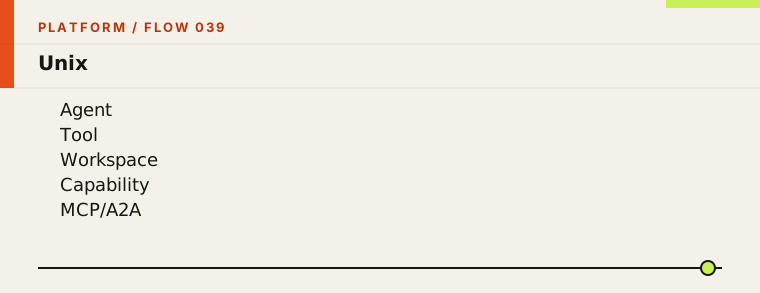
42. 最终形态其实已经很像“AI Kubernetes + Temporal + Unix”
我会用三个系统来理解:
Unix
提供:
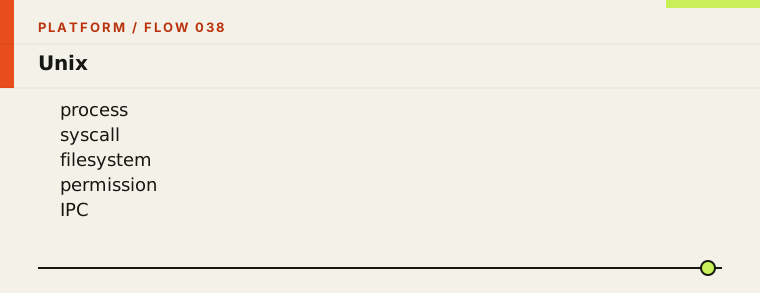
映射:
Kubernetes
提供:
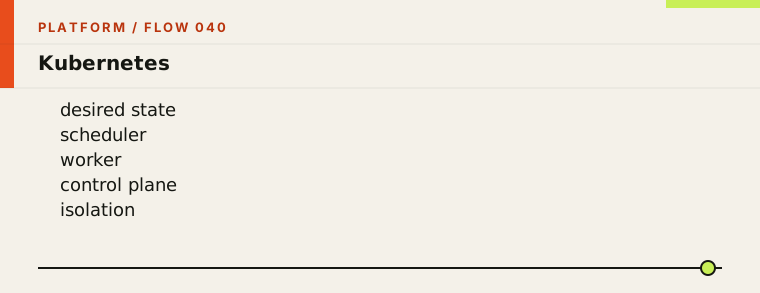
映射:
Temporal
提供:
映射:
Long-running Agent Task所以一个真正理想的 Agent OS,其实可以概括为:
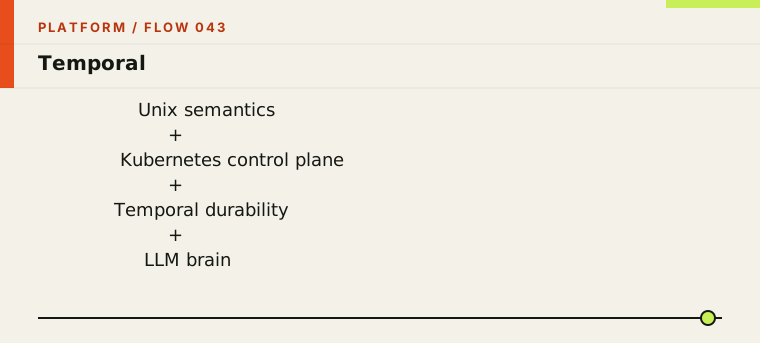
再在边界上放:
ACP / MCP / A2A再给它:
Graphiti-style memory这基本就是我认为目前理论上最漂亮、而且今天大部分组件已经能实际搭出来的体系。
最后一个非常重要的判断
如果你真准备自己做,我认为最大的错误会是:
“先实现一个万能 Agent。”更正确的起点是:
然后 Agent 本身只是这个系统中一种:
probabilistic worker一旦这么设计,未来接:
都只是 adapter,而不是重写系统。
这就是我目前认为最理想的 Agent OS / Agent Cloud 架构。